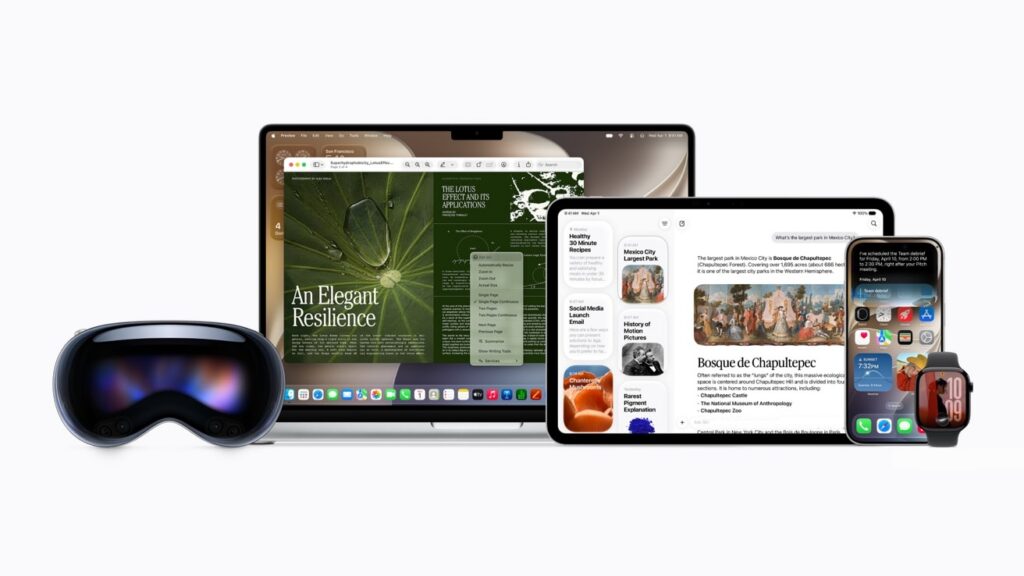
Apple affida Siri a Google

Al WWDC, Apple ha confermato che la componente cloud di Siri si basa ora su una versione personalizzata di Google Gemini, un modello da 1,2 trilioni di parametri che, secondo le indiscrezioni, costerebbe circa un miliardo di dollari all’anno in licenze.

È una scelta che fa discutere, soprattutto perché Apple ha sempre costruito la propria immagine sull’idea di controllare internamente hardware, software e servizi, oltre che sulla tutela della privacy: eppure oggi una parte fondamentale della sua strategia sull’intelligenza artificiale dipende da Google, che è anche uno dei suoi principali concorrenti.

La cosa interessante è che molte delle funzionalità più avanzate di Siri mostrate al WWDC 2024 (come la capacità di comprendere il contesto personale dell’utente, interpretare ciò che appare sullo schermo e svolgere azioni tra diverse app) non sono mai arrivate sul mercato nei tempi annunciati: dopo mesi di rinvii e persino il ritiro di alcune campagne pubblicitarie, Apple sembra aver scelto di affidarsi all’infrastruttura di Google per portare avanti questi progetti.

Il tutto arriva dopo un accordo da 250 milioni di dollari (!) raggiunto a maggio in relazione alla promozione di funzionalità di Siri che non erano ancora disponibili, e durante quello che potrebbe essere ricordato come l’ultimo keynote di Tim Cook prima delle dimissioni previste per il primo settembre.

In altre parole, Apple non ha realmente chiuso il gap nell’intelligenza artificiale con una tecnologia sviluppata interamente in casa: per il momento, ha deciso di colmarlo appoggiandosi a Google.
Le webliografie

Sono un consumatore seriale di libri (l’oggetto cartaceo ha in me un fascino indescrivibile). Negli ultimi anni, se ci fate caso, spesso alla fine, i volumi si sono ampliati con la presenza delle webliografie (o sitografie): queste, però, hanno portato una serie di problematiche che a oggi non credo siano del tutto risolte.

Mi spiego meglio: in un libro cartaceo, indicare una fonte online significa, in teoria, riportare l’URL completo: ma chi ha davvero voglia di riscrivere a mano indirizzi interminabili pieni di simboli, passando continuamente dalla carta allo schermo?

Allora mi sono fatto una domanda: non sarebbe più utile indicare solo la homepage del sito, il nome dell’autore (quando c’è) e soprattutto il titolo esatto del testo? Con titolo e autore, una ricerca su Google porta quasi sempre al risultato giusto in pochi secondi.

E, nel frattempo, la pagina resta più pulita, meno ingombrata.

Editor, mi leggete?

I blog e quella voglia di dire la propria

Una ventina d’anni fa i blog erano praticamente l’unico spazio per dire la propria online, e Google li spingeva in cima ai risultati: da lì nacque una notorietà spesso casuale e passeggera per un piccolo gruppo di persone che, altrimenti, difficilmente avrebbero avuto visibilità. Eppure erano voci interessanti: preparate, brillanti, ironiche, capaci di accendere curiosità e aprire prospettive nuove sul futuro.

Oggi lo scenario è completamente diverso: sono arrivati strumenti più immediati (ah, i social!), gli algoritmi sono cambiati, le relazioni online si sono trasformate in qualcosa di diverso e internet è diventato un luogo da frequentare con più cautela.

Non seguo più i blog come una volta (anche perché numeramente molti meno di un tempo), ma continuo a seguire quelle stesse persone attraverso altri canali: nel frattempo ne ho scoperte di nuove, continuando ad arricchirmi grazie al loro modo di vedere il mondo.

I blog, per come li conoscevamo, sono ormai un ricordo, ma questo non significa che qualcosa sia finito davvero: non si è chiusa un’epoca nel senso più definitivo, non si sono spente le possibilità. Sono soltanto cambiati i tempi e io forse sono rimasto all’idea romantica che avevo vent’anni fa.

Giornalismo e IA

Tra le mille storie laterali riguardanti l’intelligenza artificiale e il modo di fare giornalismo, ce n’è una che penso valga la pena essere raccontata.

Nei giorni scorsi si è parlato e scritto tanto di un giornalista romano arrestato per pedofilia: in tutte le redazioni è partita la caccia per sapere nome e cognome, fino a quando qualcuno ha pensato bene di chiedere alle varie piattaforme di intelligenza artificiale. È così arrivato il nome e cognome del presunto colpevole. Ma sbagliato. Con una doppia violazione, perché oltre a non segnalare che erano necessarie particolari accortezze per tutelare con l’anonimato i minori, l’Intelligenza artificiale ha anche diffuso notizie false e lesive della reputazione delle persone chiamate ingiustamente in causa. 

Gemini, intelligenza artificiale di Google, ha indicato il nome di una persona deceduta. 

ChatGpt ha fornito il nome di un giornalista vivente, con le stesse iniziali dell’arrestato ma di età diversa. 

Il più corretto è stato Grok che si è rifiutato di dare informazioni sottolineando che i minori vengono prima di qualsiasi curiosità o scoop. 

Solo dopo alcune ore Gemini e ChatGpt hanno corretto le loro risposte e smesso di dare informazioni, limitandosi a fornire link sull’arresto.

Il problema dell’accuratezza delle fonti riguarda da anni il nostro sistema giornalistico: è questo il nuovo modello di fare informazione?